

Last Updated on 2 anni | Published: 01/03/2024
Persistenza JPA
Jakarta e Hibernate
La persistenza, nel contesto delle tecnologie di sviluppo software e dei database, si riferisce alla capacità di conservare lo stato di un oggetto o di dati oltre il termine di esecuzione del programma. In altre parole, la persistenza consente di memorizzare in modo permanente le informazioni, in modo che siano disponibili anche dopo che l’applicazione o il sistema è stato arrestato o riavviato.
In sostanza, la persistenza garantisce che i dati mantengano la loro esistenza anche oltre il ciclo di vita temporaneo dell’applicazione, garantendo una conservazione a lungo termine delle informazioni.
La persistenza dei dati è un elemento cruciale nella progettazione e nello sviluppo delle applicazioni moderne. In questo contesto, Java Persistence API (JPA) emerge come uno standard fondamentale, consentendo agli sviluppatori di gestire la persistenza dei dati in modo efficiente e indipendente dalla piattaforma Jakarta EE rappresenta un ecosistema robusto e aperto per lo sviluppo di applicazioni enterprise in Java.
All’interno di Jakarta EE, la persistenza JPA gioca un ruolo centrale, offrendo uno standard comune per l’accesso ai dati persistenti.
Jakarta EE abbraccia e supporta JPA come parte integrante, garantendo la portabilità delle applicazioni su diverse implementazioni del server.
Hibernate, da parte sua, rappresenta una delle implementazioni più popolari e mature di JPA. Inizialmente sviluppato come un framework ORM (Object-Relational Mapping) autonomo, Hibernate ha contribuito significativamente alla definizione degli standard JPA.
E’ importante sottolineare che JPA è uno standard, mentre Hibernate è un’implementazione specifica di questo standard.
Le principali differenze tra Hibernate e JPA risiedono nella portabilità del codice. JPA, essendo uno standard, consente agli sviluppatori di scrivere codice che è indipendente dall’implementazione sottostante. Questo offre la flessibilità di cambiare l’implementazione JPA senza dover riscrivere l’applicazione.
Al contrario, Hibernate, pur essendo potente e ricco di funzionalità, può comportare una dipendenza più stretta dall’implementazione specifica.
Nel corso di questa presentazione, esploreremo le funzionalità chiave di Jakarta, evidenziando come il suo utilizzo possa migliorare la persistenza delle informazioni nelle vostre applicazioni. Vedremo come Jakarta semplifica il mapping oggetto-relazionale, ottimizza le operazioni di accesso ai dati e garantisce la coerenza delle informazioni nel tempo.
Eclipse Maven - Progetto WAR
Guida Pratica con le Servlet
La realizzazione di un progetto web robusto e scalabile richiede la scelta di strumenti adeguati e una corretta configurazione. In questo contesto, Eclipse rappresenta un ambiente di sviluppo integrato (IDE) molto popolare, mentre Maven facilita la gestione delle dipendenze e la compilazione del progetto. Integrare Java Persistence API (JPA) ed eventuali altre dipendenze.
Maven, uno strumento di gestione di progetti basato su concetti di configurazione, diventa essenziale per gestire dipendenze e cicli di vita del progetto.
La configurazione di Maven avviene attraverso il file “pom.xml” (Project Object Model). Qui, specificare le dipendenze necessarie per il progetto, come ad esempio l’implementazione di JPA, a tal proposito il progetto dovrà essere configurato attraverso le Properties per aggiungere la Project Facets JPA. Maven si occupa automaticamente di scaricare e gestire tali dipendenze, semplificando il processo di sviluppo. Di seguito un esempio di progetto Maven che genera un file WAR:

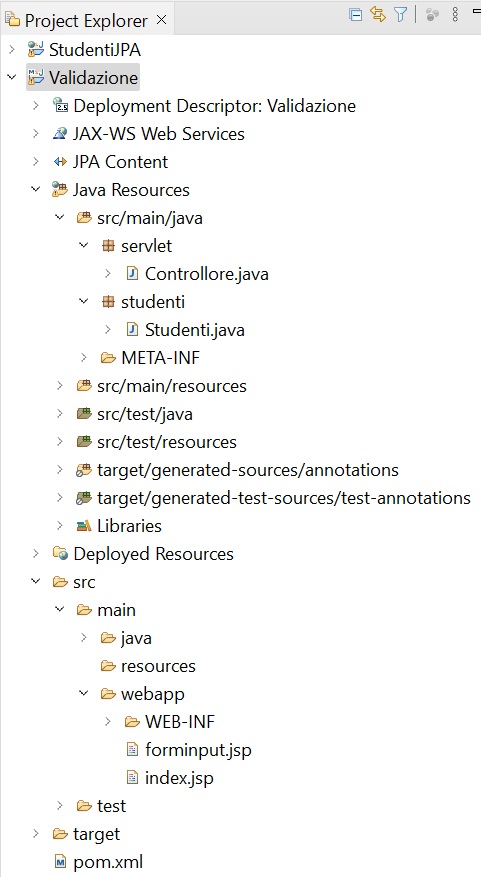
<dependencies>
<!– Implementazione JPA specifica (Hibernate è comunemente utilizzato) –>
<dependency>
<groupId>org.hibernate</groupId>
<artifactId>hibernate-core</artifactId>
<version>6.0.0.Final</version>
</dependency>
<!– Driver JDBC per MySQL –>
<dependency>
<groupId>mysql</groupId>
<artifactId>mysql-connector-java</artifactId>
<version>8.0.23</version>
</dependency>
</dependencies>
pom.xml
Configurare l’unità di persistenza è cruciale, e ciò avviene attraverso il file “persistence.xml“. Questo file definisce l’unità di persistenza, specificando la connessione al database, le classi delle entità, e altre proprietà. La configurazione attraverso questo file è specifica di JPA e non di Hibernate direttamente.
Per Hibernate la configurazione avviene solitamente attraverso il file hibernate.cfg.xml o tramite configurazioni programmatiche. Tuttavia quando si utilizza Hibernate come provider il file di persistenza è utilizzato per configurare le unità di persistenza oltre alle informazioni relative alla persistenza.
Nel caso in cui non specificassi esplicitamente le classi di entità nel file persistence.xml, JPA (Java Persistence API) gestirà comunque automaticamente tutte le classi annotate come entità all’interno del tuo progetto. Vediamo un esempio:
<?xml version=”1.0″ encoding=”UTF-8″?>
<persistence xmlns=”http://xmlns.jcp.org/xml/ns/persistence” xmlns:xsi=“http://www.w3.org/2001/XMLSchema-instance“
xsi:schemaLocation=”http://xmlns.jcp.org/xml/ns/persistence http://xmlns.jcp.org/xml/ns/persistence/persistence_2_2.xsd”
version=”2.2“>
<persistence-unit name=”NomeUnitaPersistenza” transaction-type=”RESOURCE_LOCAL”>
<properties>
<!– Configurazioni per la connessione MySQL –>
<property name=“jakarta.persistence.jdbc.url” value=“jdbc:mysql://localhost:3306/DatabaseName“/>
<property name=“jakarta.persistence.jdbc.user” value=”Username“/>
<property name=“jakarta.persistence.jdbc.password“ value=”Password“/>
<property name=”jakarta.persistence.jdbc.driver” value=“com.mysql.cj.jdbc.Driver”/>
<!– Altre configurazioni JPA –>
<property name=“hibernate.dialect” value=“org.hibernate.dialect.MySQLDialect”/>
<property name=“hibernate.show_sql” value=”true“/>
<property name=“hibernate.format_sql” value=”true“/>
</properties>
</persistence-unit>
</persistence>
hibernate.dialect
Questa proprietà specifica il dialetto SQL da utilizzare per interagire con il database. Il dialetto SQL fornisce una traduzione tra il linguaggio di interrogazione Hibernate e il linguaggio SQL specifico del database. Puoi scegliere il dialetto appropriato in base a quello che sui utilizza ad esempio
org.hibernate.dialect.OracleDialect
hibernate.format_sql:
Questa proprietà, quando impostata su “true”, formatta le istruzioni SQL stampate nella console del log in modo più leggibile. Questo rende più facile la lettura e l’analisi delle query, specialmente quando si lavora su progetti complessi.
hibernate.show_sql:
Quando impostato su “true”, questa proprietà indica a Hibernate di stampare tutte le istruzioni SQL generate nella console del log. Questo può essere utile per scopi di debug e per capire esattamente quali query vengono eseguite.
jakarta.persistence.jdbc
A partire dalla versione 5, Hibernate supporta Jakarta Persistence API (JPA).
Jakarta EE è l’evoluzione di Java EE (Enterprise Edition) e, di conseguenza, le specifiche di JPA sono ora gestite dalla Eclipse Foundation sotto il nome Jakarta Persistence.
Quando si utilizza Hibernate come provider non si utilizza direttamante l’ oggetto Session, come avviene con Hibernate puro attraverso la classe HibernateUtil.class. Invece si utilizza l’ oggetto EntityManager per interagire con l’ entità gestita dal contesto di persistenza. Ecco un esempio:
EntityManagerFactory emf = Persistence.createEntityManagerFactory(“nome_persistenza”);
EntityManager em = emf.createEntityManager();
em.close();
emf.close();
Vantaggi di Hibernate
Hibernate è un framework di persistenza potente e ampiamente utilizzato in ambienti Java. Ti permette di gestire la persistenza dei dati in modo efficace, astratto dalle specifiche del database sottostante. Puoi concentrarti sulla logica dell’applicazione senza preoccuparti dei dettagli di accesso ai dati.
Vediamo i principali vantaggi quali sono:
Object-Relational Mapping
Mappa oggetti Java direttamente sulle tabelle del database, semplificando l’interazione tra il codice Java e i dati persistenti.
Hibernate Query Language
Fornisce un linguaggio di query orientato agli oggetti, facilitando le operazioni di interrogazione del database senza dover scrivere SQL diretto.
Transazioni
Gestisce automaticamente le transazioni, garantendo l’integrità dei dati.
Portabilità del Database
Hibernate offre una maggiore portabilità del codice, consentendoti di cambiare il database sottostante senza dover modificare il codice dell’applicazione.
Cache
Supporta la gestione della cache per migliorare le prestazioni, riducendo il numero di query eseguite sul database.
Eventi e Interceptor
Permette di intercettare e rispondere agli eventi di persistenza, consentendo personalizzazioni avanzate.
Object Relational Mapping
Mappatura delle Entità
In Hibernate, la mappatura delle tabelle del database a oggetti Java è gestita attraverso le entità. Un’ entità rappresenta una tabella nel database e ogni istanza di quell’entità rappresenta una riga in quella tabella. L’annotazione fondamentale per dichiarare un’entità è @Entity
@Entity
@Table(name = “studenti”)
public class Studenti{
@Id
@GeneratedValue(strategy = GenerationType.IDENTITY)
private Long id;
@Column(name = “nome”)
private String nome;
@Column(name = “cognome”)
private String cognome;
// Altri campi, costruttori, getter e setter
}
L’annotazione @Column viene utilizzata per mappare un campo di classe a una colonna del database. Può anche essere utilizzata per specificare il nome della colonna nel database. Nell’esempio, abbiamo utilizzato @Column per mappare i campi nome e cognome a colonne specifiche, anche se poi abbiamo utilizzato lo stesso identificativo.
E’ possibile anche omettere questa annotazione quando non è necessaria la personalizzazione delle colonne del database e si desidera accettare le impostazioni predefinite. Hibernate, per impostazione predefinita, utilizzerà il nome del campo come nome della colonna e applicherà le impostazioni di default del database per il tipo di dati della colonna.
Il tipo di generazione della chiave primaria è specificato con @GeneratedValue. Nell’esempio, GenerationType.IDENTITY indica l’uso dell’identità del database per la generazione automatica della chiave primaria.
ORM - Validazione Hibernate
La validazione in un contesto Hibernate/JPA si riferisce a un meccanismo per garantire che i dati immessi nell’applicazione rispettino determinati vincoli prima di essere persistiti nel database. Ciò contribuisce a mantenere l’integrità dei dati e a migliorare la sicurezza e l’affidabilità dell’applicazione.
La validazione può includere vincoli come la presenza di valori (@NotNull), la lunghezza massima di una stringa (@Size), la validità di un indirizzo email (@Email), e molti altri. Le annotazioni di validazione in genere vengono applicate ai campi delle entità e vengono verificate prima che i dati vengano salvati nel database.
public class Studenti {
@Id
private Long id;
@NotEmpty(message=”Il nome non può essere vuoto“)
private String nome;
@NotEmpty(message=”Il cognome non può essere vuoto”)
private String cognome;
private String citta;
@Past(message=”La data deve essere nel passato”)
// metodi get e set
}
Ovviamente per gestire la validazione dei dati, ad esempio inseriti attraverso un form html, è necessario introdurre una dipendenza nel pom del progetto ed è la seguente:
<groupId>org.hibernate.validator</groupId>
<artifactId>hibernate-validator</artifactId>
<version>6.0.0.Final</version>
</dependency>
Se la dipendenza è Hibernate Validator versione 6.0.0.Final, stiamo utilizzando il validatore di Hibernate basato su javax.validation. Tuttavia, vale la pena notare che, se il progetto si sta gradualmente spostando verso Jakarta EE 9 o versioni successive, potremmo voler migrare a Jakarta Validation API.
Mostriamo di seguito le annotazioni di validazione più comuni fornite da Hibernate Validator:
@NotNull: Il campo deve essere non nullo.@NotBlank: Il campo deve essere non nullo e contenere almeno un carattere non spaziale.@NotEmpty: Il campo deve essere non nullo e non vuoto. Questa annotazione è principalmente utilizzata per collezioni, mappe e stringhe.@Size: Limita la lunghezza di una stringa o la dimensione di una collezione o mappa.@Email: Il campo deve contenere un indirizzo email valido.@Pattern: Il campo deve rispettare un determinato pattern regolare.@Mine@Max: Limita il valore minimo e massimo di un campo numerico.@DecimalMine@DecimalMax: Limita il valore minimo e massimo di un campo numerico decimale.@Positivee@Negative: Verifica che un numero sia positivo o negativo.@PositiveOrZeroe@NegativeOrZero: Verifica che un numero sia positivo o zero, o negativo o zero.@Paste@Future: Verifica se una data è nel passato o nel futuro.@PastOrPresente@FutureOrPresent: Verifica se una data è nel passato o presente, o nel futuro o presente.@CreditCardNumber: Verifica se una stringa rappresenta un numero di carta di credito valido.@AssertTruee@AssertFalse: Verifica che un valore booleano siatrueofalse.@Null: Verifica che il campo sia nullo.@NotEmptye@NotNullper collezioni e mappe: Verifica che una collezione o mappa non sia vuota o nulla.@FutureOrPresent: Verifica se una data è nel futuro o presente.@PastOrPresent: Verifica se una data è nel passato o presente.
Per la validazione di un oggetto si inizia creando una ValidatorFacrory che è il punto di ingresso principale per l’API di validazione di Jakarta EE (in questo caso, Hibernate Validator).
ValidatorFactory vf = Validation.buildDefaultValidatorFactory();
Validation.buildDefaultValidatorFactory() restituisce una factory di validazione ( vf ) predefinita basata sul provider di validazione configurato nel tuo classpath.
Successivamente, ottieni un’istanza di Validator dalla ValidatorFactory.
Validator è l’oggetto responsabile dell’esecuzione effettiva delle operazioni di validazione.
Validator valid = vf.getValidator();
Per eseguire la validazione dell’oggetto st, Classe Studenti, utilizzando il Validator. Mentre validate(st) restituisce un insieme di oggetti ConstraintViolation. Questi oggetti contengono informazioni dettagliate sulle violazioni di vincoli di validazione.
Set<ConstraintViolation<Studenti>> violations = valid.validate(st);
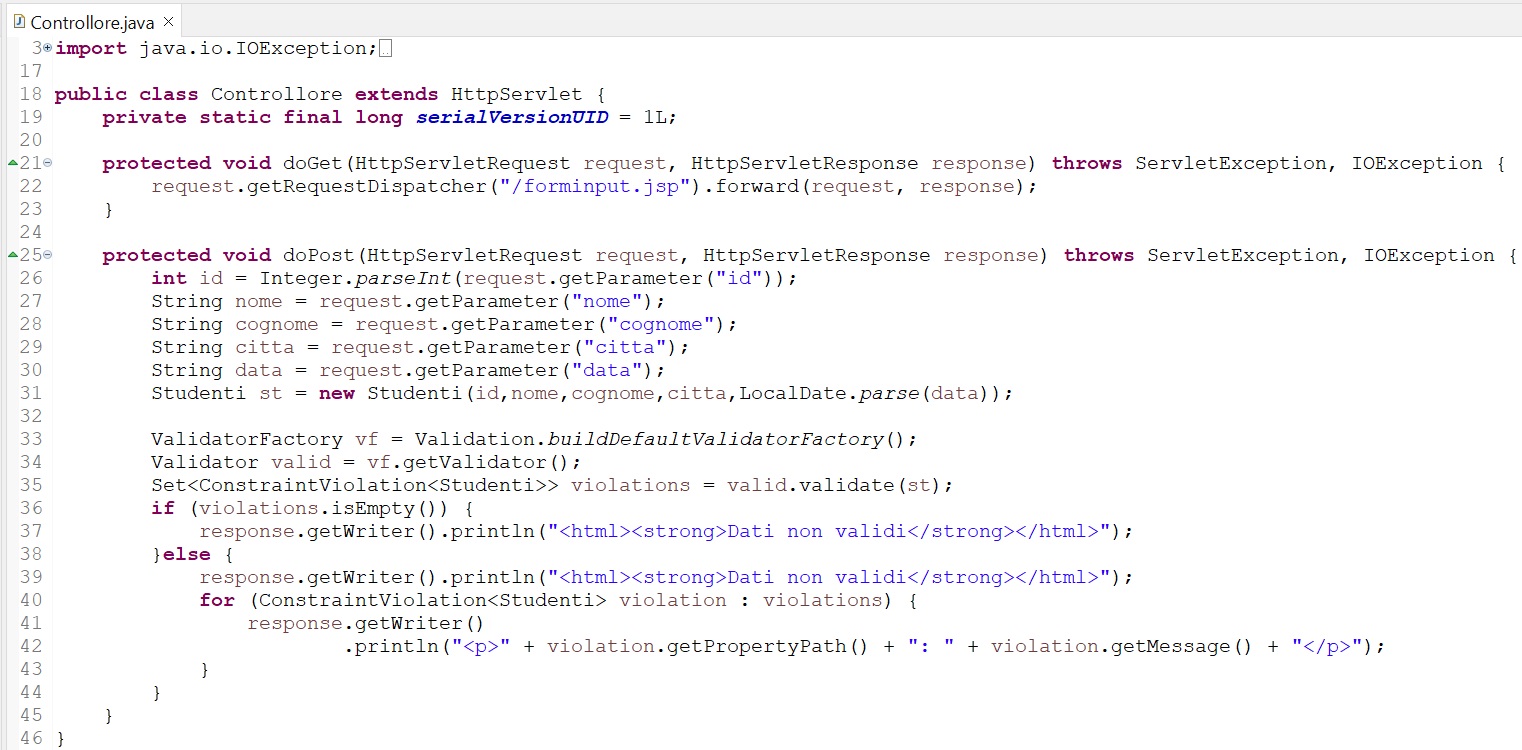
Vediamo come la sevlet con una request POST gestisce la validazione dell’ oggetto st, i cui attributi vengono passati attraverso un form html
ValidatorFactory vf = Validation.buildDefaultValidatorFactory();
Validator valid = vf.getValidator();
Set<ConstraintViolation<Studenti>> violations = valid.validate(st);
if (violations.isEmpty()) {
response.getWriter().println(“<html><h1>Dati Validi!</h1></html>”);
} else {
response.getWriter().println(“<html><h1>Errori di Validazione:</h1>”);
for (ConstraintViolation<Studenti> violation : violations) {
response.getWriter().println(“<p>”+violation.getPropertyPath()+”:”+violation.getMessage()+”</p>”);
}
}
Download progetto: WAR Validazione
 validazione.zip
(zip, 17KB)
HQL - Hibernate Query Language
Hibernate Query Language (HQL) è un linguaggio di query orientato agli oggetti utilizzato con il framework di persistenza Hibernate.
HQL fornisce un modo intuitivo e orientato agli oggetti per interagire con il database senza dover scrivere query SQL tradizionali. Invece di concentrarsi sulla struttura del database, HQL si basa sulle classi Java e sugli oggetti associati.
Differenziando HQL da MySQL, è importante notare che MySQL è un sistema di gestione di database relazionale (RDBMS), mentre HQL è un linguaggio di query specifico di Hibernate.
Mentre MySQL utilizza query SQL per interagire con il database seguendo la sua struttura relazionale, HQL astrae da questa struttura, permettendo agli sviluppatori di interagire con il database attraverso oggetti Java e relazioni tra di essi.
In altre parole, MySQL è un database, mentre HQL è un linguaggio di query utilizzato insieme a Hibernate per semplificare la gestione della persistenza dei dati in un’applicazione Java invece delle tabelle e delle colonne del database.
In sintesi, HQL semplifica l’interazione tra un’applicazione Java e un database relazionale attraverso il framework Hibernate, fornendo un’astrazione orientata agli oggetti delle operazioni di query. Questo contrasta con MySQL, che è un sistema di gestione del database relazionale che utilizza il linguaggio SQL tradizionale per interagire con i dati in un ambiente di database relazionale.
In Java Persistence API (JPA), il metodo persist() viene utilizzato per inserire un’entità nel database. JPA è una specifica Java che fornisce uno standard per l’interazione con i database relazionali attraverso oggetti Java, consentendo di gestire l’accesso e la manipolazione dei dati in modo più orientato agli oggetti.
EntityManagerFactory emf = Persistence.createEntityManagerFactory(“persistenza”);
EntityManager em = emf.createEntityManager();
EntityTransaction tx = em.getTransaction();
try {
tx.begin();
em.persist(nuovoStudente);
tx.commit();
} catch (Exception e) {
if (tx != null && tx.isActive()) {
tx.rollback();
}
e.printStackTrace();
} finally {
em.close();
}
Il rollback è una operazione che annulla gli effetti di una transazione, riportando il sistema allo stato che aveva prima che la transazione fosse iniziata. Nel contesto di JPA (Java Persistence API) e delle operazioni di persistenza dei dati in un database, il rollback è spesso utilizzato quando si verificano errori durante l’esecuzione di una transazione, permettendo di evitare la modifica permanente dei dati nel database.
Di seguito il download del progetto Maven dove viene mostrata una implementazione della EntityManager , la mappatura della tabella del database a oggetti Java ed il metodo persist(entity) per inserire una entità nel database:
Download progetto: WAR CrudPersist
crudpersist.zip
(zip, 19KB)
Il metodo createQuery è un metodo dell’interfaccia EntityManager in JPA (Java Persistence API), che viene utilizzato per creare query basate su JPQL (Java Persistence Query Language) o HQL (Hibernate Query Language). JPQL e HQL sono linguaggi di query orientati agli oggetti utilizzati per interrogare dati dalle entità del tuo modello di oggetti. Mostriamo la firma di base del metodo createQuery:
em.createQuery(qhql):Query
La sintassi di una qhql varia a seconda di ciò che si vuole ottenere e può essere scritta con o senza la parola chiave SELECT vediamo alcuni esempi:
s come alias indica che stai selezionando tutte le colonne dell’entità StudentiPer selezionare colonne specifiche dell’ entità Studenti
Di seguito una possibile implementazione di un metodo che ritorna la lista di studenti ottenuta con createQuery:
Query q = em.createQuery(qhql);
List<Studenti> lista = q.getResultList();
return lista;
}
Vediamo altre opzioni più comuni che si possono utilizzare con il metodo createQuery, come le query parametriche :
Query q = em.createQuery(qhql)
q.setParameter(“city“,”napoli“)
List<Studenti> lista = q.getResuktList()
String qhql = “UPDATE Studenti s set s.citta = : city WHERE s.id =:codice“
Query q = em.createQuery(qhql)
EntityTransaction tx = em.getTransaction();
try {
tx.begin();
Query q = em.createQuery(qhql);
q.setParameter(“city“, “Trieste”);
q.setParameter(“codice“, 2);
q.executeUpdate();
tx.commit();
} catch (Exception e) {
if (tx != null && tx.isActive()) {
tx.rollback();
}
e.printStackTrace();
}
Download progetto: WAR CrudQuery
crudquery.zip
(zip, 21KB)
Un metodo per recuperare un’ entità dal database basandosi sulla chiave primaria è find() dell’ EntityManager. Questo metodo è parte dell’interfaccia Java Persistence API (JPA) e offre un modo semplice per ottenere un’entità quando si conosce il suo identificatore univoco. Vediamo l’ utilizzo:
Studenti studente = em.find(Studenti.class,id)
Il metodo remove() potrebbe rimuovere l’ entità ottenuta con il find(), vediamo una implementazione:
try {
tx.begin();
em.remove(st);
tx.commit();
} catch (Exception e) {
if (tx != null && tx.isActive()) {
tx.rollback();
}
e.printStackTrace();
}
Tipi di Relazioni in Hibernate JPA
Le relazioni tra entità sono uno degli aspetti più potenti di Hibernate JPA. Consentono di modellare le relazioni tra tabelle del database attraverso relazioni in Java.
Query di SELECT
Ecco un esempio di relazione 1:1 (@OneToOne) tra due entità: Studente e DettagliStudente. Ogni studente ha un unico dettaglio associato e ogni dettaglio è associato ad uno e un solo studente.
@Entity
@Table(name = “studenti“)
public class Studenti {
@Id
private int id;
private String nome;
private String cognome;
private String citta;
private LocalDate data;
@OneToOne(mappedBy = “studente“,cascade = CascadeType.ALL,fetch = FetchType.LAZY)
private Dettagli dettaglio;
// getter setter
}
Nell’ entità Studenti, @OneToOne con mappedBy = "studente" indica che questa entità è il lato proprietario della relazione e che l’associazione è mappata dall’entità Dettagli attraverso il campo studente.
La cascata CascadeType.ALL indica che le operazioni di persistenza, aggiornamento e rimozione eseguite sull’entità Studente si rifletteranno anche sull’entità Dettagli associata.
Nell’entità Dettagli, l’annotazione @OneToOne @JoinColumn(name = "id") indica che questa entità contiene la chiave esterna id che fa riferimento alla chiave primaria della tabella Studente.
Questa è la modalità più comune per mappare relazioni uno a uno con Hibernate JPA.
Fetch Lazy:
- Se utilizzi un fetch lazy, i dati relativi all’entità associata vengono caricati solo quando effettivamente ne hai bisogno. Ad esempio, se hai una relazione uno a uno tra
StudentieDettaglie utilizzi un fetch lazy, i dettagli dello studente verranno caricati solo quando effettivamente accedi a quel campo.
- Con un fetch eager, i dati relativi all’entità associata vengono caricati insieme all’entità principale durante la query. Questo può essere utile quando sai che avrai sempre bisogno dei dettagli e vuoi evitare ulteriori query per recuperare i dati associati.
Se desideri recuperare sia gli studenti che i loro dettagli nella stessa query HQL, è possibile farlo utilizzando una join. Puoi usare una query HQL che include una clausola JOIN per ottenere i dati da entrambe le tabelle. Ecco un esempio:
String qhql =”SELECT s, d FROM Studenti s
INNER JOIN s.dettaglio d”
Questa query restituirà un elenco di array di oggetti, dove ogni array contiene i valori degli attributi delle tabelle Studente e Dettagli.
Query q = em.createQuery(qhql,Object[].class);
List<Object[]> lista = q.getResultList();
In una pagina di risposta possiamo accedere alla lista degli studenti e dei dettagli utilizzando l’ attributo precedentemente impostato nella richiesta, così come avviene quando si utilizzano le Servlet, vediamo:
<head>
<%List<Object[]> lista= (List<Object[]>)request.getAttribute(“lista”); %>
</head>
<body>
<%for(Object[] riga:lista){ %>
<%= ((Studenti) riga[0]).getCognome()%>
<%= ((Dettagli) riga[1]).getEmail() %>
<br>
<%} %>
</body>
Query di INSERT – persist()
Sfruttando la relazione @OneToOne tra Studenti e Dettagli vediamo un esempio dove un Form invia i parametri di Studenti e Dettagli ad una Servlet e successivamente salvati nel database utilizzando l’ EntityManager
Il prossimo download è un esempio di relazione OneToOne tra Studenti e Dettagli. L’ applicazione implementa query di Select e di Insert con entità incapsulate:
Download progetto: WAR Progetto OneToOne
onetoone.zip
(zip, 22KB)
In un modello di database, una relazione 1:molti (@OneToMany) si verifica quando un record in una tabella può essere associato a uno o più record in un’altra tabella. Nel nostro caso, consideriamo una relazione uno a molti tra la tabella Studenti e la tabella Voti, dove ogni studente può avere più voti registrati in periodi diversi.
Vediamo le entità:


-
onetomany.zip
(zip, 23KB)
Good day very cool site!! Guy .. Beautiful .. Superb ..
I’ll bookmark your web site and take the feeds additionally?
I’m glad to search out a lot of useful info here within the publish, we want
work out extra techniques on this regard, thanks for sharing.
. . . . .
Grazie
I am not sure where you’re getting your information, but great topic.
I needs to spend some time learning much more or understanding more.
Thank you for excellent info I was looking for this info
for my mission.
Mi fa piacere, a presto