

Last Updated on 2 anni | Published: 18/05/2024
MySql - RDBMS
Un database fa riferimento ad un archivio dati strutturato (omogeneo per contenuti e formato) memorizzati in un computer. Lo scopo principale è quello di avere una gestione e condivisione dei dati, realizzare aggiornamenti delle informazioni e consentire anche l’ esecuzione di ricerche piuttosto complesse.
Un server di database invece esegue un sistema di gestione del database e fornisce servizi di database ai client.
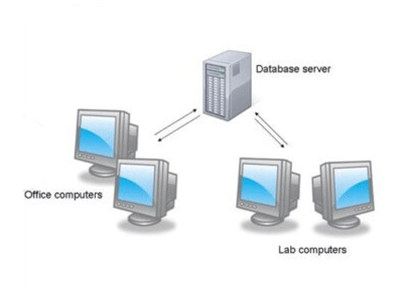
Database Management System - DBMS
Il sistema software progettato per consentire la creazione la manipolazione ed interrogazione del database è il Database Management System (DBMS) detto anche gestore o motore del database.
I client possono accedere al database tramite una dedicata applicazione front-end (esempio applicazione java) che dovrà visualizzare i dati richiesti oppure tramite una applicazione back-end che viene eseguita sul server e gestisce il database
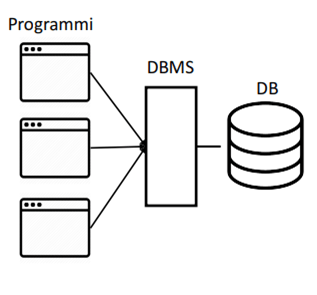
- DBMS sono componenti software specializzati nel gestire grandi quantità di dati
- Si interpone tra le applicazioni e la memoria di massa
- I dati non appartengono ad una singola applicazione ma ad essi si accede mediante il DBMS
- I dati non sono gestiti dalle singole applicazioni ma da un DBMS che offre una interfaccia comune a tutte le applicazioni.
I vantaggi di gestire una base dati con queste modalità sono:
- Condivisione del dato
- Ridurre la ridondanza dei dati, ovvero l’eliminazione di varie copie dello stesso dato.
- Ridurre l’ inconsistenza, ovvero la conservazione del dato in vari formati diversi tra di loro.
Database e Protocolli
I DBMS in commercio oggi non sono tutti dello stesso tipo e basano il loro funzionamento su protocolli non comuni a tutti.
- Databse Relazionali gestiscono i dati distribuiti su varie tabelle collegate tra di loro seguendo il modello relazionale molto intuitivo.
- Database orientato agli oggetti che collega tra loro pacchetti che appartengono allo stesso gruppo. Un set di dati viene associato con tutti i suoi attributi ad un unico oggetto, di conseguenza tutte le informazioni sono direttamente disponibili, invece che distribuirli e ricercarli da varie tabelle.
- Database distribuiti, ovvero non limitato ad un sistema ma distribuito su più siti, ovvero su più server o attraverso una rete di server in più posizioni. Dobbiamo gestire il database in modo tale che assomigli a uno solo per gli utenti.
- Database NoSql che utilizzano una varietà di modelli per accedere e gestire i dati. Sono una soluzione per molte applicazioni come dispositivi mobile web e videogiochi che richiedono un database flessibile, scalabile con prestazioni elevate.
- Il database Grafo che risulta molto più veloce nella gestione di insiemi di dati, rispetto a tabelle relazionate.
RDBMS - Modello Relazionale
La gestione elettronica dei dati è caratterizzata ad oggi da modelli di database relazionali, ovvero dati distribuiti in più tabelle opportunamente collegate affinche si abbia una più ampia e flessibile gestione delle informazioni. Di seguito elenchiamo i sistemi più comuni per la gestione delle base dati, per poi occuparci di MySql e del suo linguaggio SQL:
- Db2 è un sistema relazionale di gestione database di proprietà IBM
- Microsoft SQL Server di proprieta Microsoft
- MySql è un RDBMS open source (indica un software il cui codice sorgente è rilasciato con una licenza che lo rende modificabile o migliorabile da parte di chiunque) ed è un prodotto Oracle.
- PostgreSQL è un sistema di gestione database relazionale a oggetti (ORDBMS) gratuito.
- Oracle Database di proprietà Oracle con licenze a pagamento.
- SQLite è una libreria di dominio pubblico che contiene un sistema di gestione del database relazionale.
Il Database MySql nasce nel 1995 e subisce vari cambiamenti di proprietà approdando ad Oracle nel 2010. Il suo approccio con le informazioni è caratterizzato da relazioni dove i dati sono custoditi in strutture separate chiamate tabelle. Quindi è possibile avere ad esempio una tabella Clienti dove si registreranno i dati anagrafici ed una seconda tabella Ordini collegata alla precedente dove si registreranno per ogni cliente i relativi ORDINI.
Le relazioni in definitiva sono legami logici tra tabelle che permettono di aggregare informazioni. I tipi di relazioni che si possono creare con MySql sono tre :
1 a 1
1 a molti
molti a molti
Come organizzare e gestire relazioni di questo tipo verrà trattato negli articoli successivi. Occupiamoci adesso dell’ installazione di un server di database Mysql in modalità locale.
MySql WorkBench
Client e Server Database
Per architettare i database spesso gli sviluppatori utilizzano MySql Workbench che è uno strumento innanzitutto visivo, fornisce la modellazione dei dati, un ambiente di sviluppo SQL (Structured Query Language) e strumenti di amministrazione e configurazione del server.
MySql Workbench è disponibile per varie piattaforme, come Windows, Linux e Mac. Il link da cui potete scaricare il prodotto è il seguente:
https://dev.mysql.com/downloads/workbench/
Al termine sul vostro PC verrà installato un Server MySql (localhost:3306) ed un Client (Workbench) programmato per modellare in forma visiva i vostri database e gestire i dati attraverso un Linguaggio SQL, di cui parleremo più avanti in questo articolo.

Attraverso la schermata Home (figura in alto) possiamo accedere all’ unica istanza di database MySql creata durante il setup (MySql80), il cui utente è root ( password impostata durante l’ installazione ). Altre possibilità offerte dal client Workbench le vedremo dopo, come ad esempio l’ utilizzo dei diagrammi EER.
Sempre durante l’ installazione si può decidere di avviare il Server MySql al bootstarp del Sistema Operativo, ed è ciò che è stato fatto, quindi dopo l’ autenticazione (MySql80) si può passare alla creazione e gestione di base dati, anche relazionate se necessario.
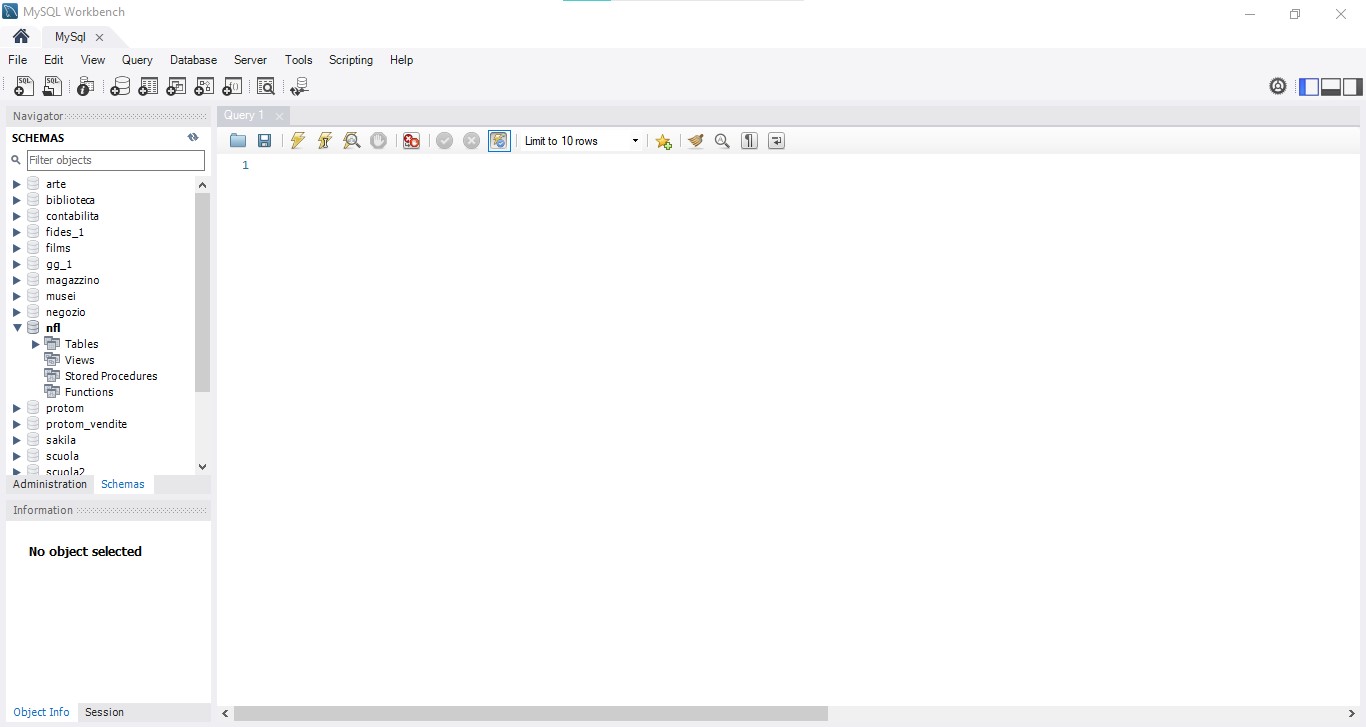
La fase successiva all’ autenticazione è la creazione degli Schemas, ovvero collezione di oggetti come tabelle, viste, funzioni e procedure. Lo Schema è quello che viene anche chiamato base dati, a cui ci si collega ad esempio attraverso un linguaggio di programmazione. Per la creazione degli schemas ci si può affidare alla parte visuale di Workbench utilizzando il bottone preposto, in alto sulla barra degli strumenti.
La quarta icona da sinistra vi consente di creare Schemas, mentre con la prima icona (SQL) è possibile aprire un ambiente per scrivere query in linguaggio SQL con cui si può anche interagire con il Server, per definire Schema, Tabelle ed altro.
DDL - Data Definition Language
Un linguaggio molto sintetico, dichiarativo e non procedurale, attraverso cui è possibile interagire con un database è l ‘SQL (Structured Query Language). Il termine query indica una interrogazione, ovvero una operazione di lettura o scrittura da svolgere su una base dati.
Con la sigla DDL si fa riferimento a tutta una serie di comandi o query per creare o modificare lo schema del database e dei suoi oggetti. Alcuni comandi sono:
CREATE
DROP
ALTER
TRUNCATE
RENAME
Utilizziamo l’ ambiente di scrittura SQL (prima icona da sinistra sulla barra degli strumenti in alto) per interagire con il server e definire nuovi Schemas oppure Database:
CREATE SCHEMA nomeschema
CREATE DATABASE nomedatabase
Scrivere i comandi o query a partire dalla riga 1, non è obbligatorio utilizzare il punto e virgola finale, se si tratta di una sola query. Per l’ esecuzione è possibile cliccare sulla terza icona da sinistra, in alto nella barra degli strumenti.
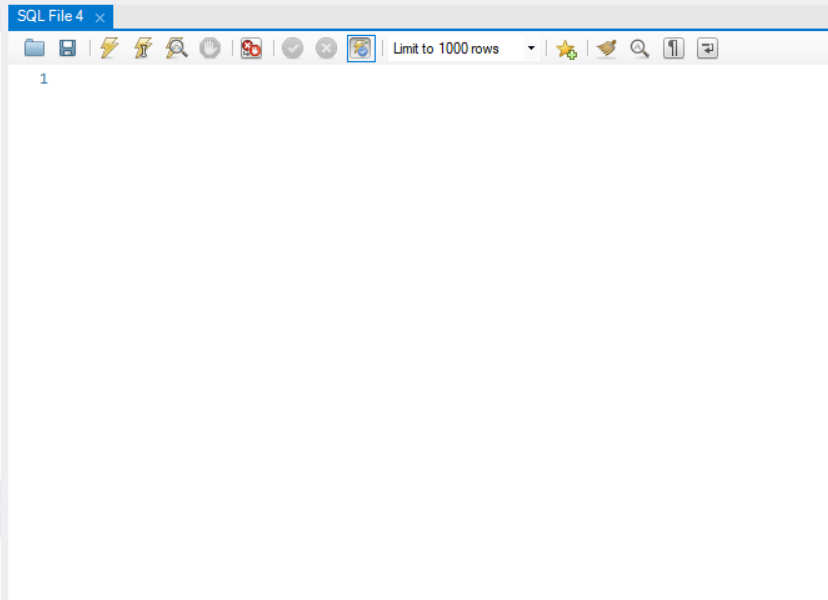
Per eliminare degli Schema è possibile utilizzare il seguente comando SQL
DROP SCHEMA nomescema
DROP DATABASE nomedata
TRUNCATE, RENAME, CREATE ed ALTER vengono impiegati per la definizione di tabelle ed indici. Dopo lo Schema si passa alla creazione di tabelle ovvero strutture tipizzate adatte a memorizzare dati in maniera permanente e per questo abbiamo il client Workbench che facilita il compito attraverso procedure guidate, infatti in corrispondenza della raccolta Tables, dello schema selezionato, si possono inizializzare nuove tabelle utilizzando come pulsante la quinta icona da sinistra, in alto sulla barra degli strumenti, oppure con il tasto destro del mouse su Tables e selezionare Create Table
Create Table - Datatype
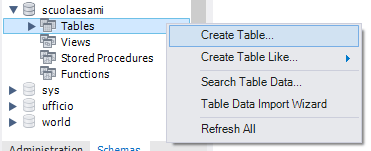
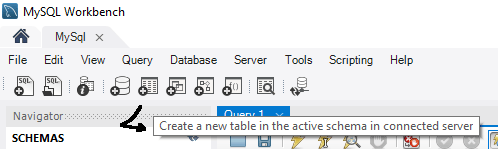
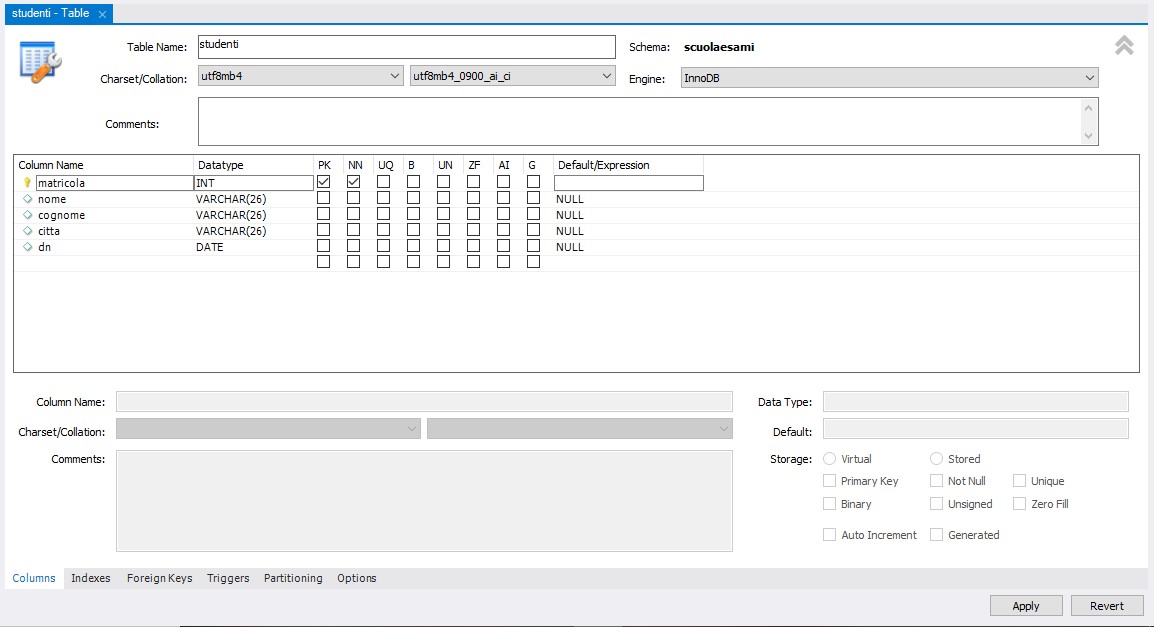
Quindi la creazione di tabelle avviene attraverso una interfaccia grafica del client Workbench, dove sarà possibile definire il nome della tabella (studenti) ed il tracciato record composto da campi tipizzati secondo il Datatype di MySql. Un esempio di Tabella (studenti) dello Schema ‘scuola‘ è riportato di seguito:
Primary Key - Vincolo di Integrità
Comporre un tracciato record, ovvero la struttura che dovrà contenere i dati, è abbastanza semplice, infatti bisognerà dare il nome ad ogni campo ed il relativo tipo, selezionandolo dalla colonna Datatype. Come possiamo notare ad ogni campo è possibile assegnare un particolare ruolo, come la PK (Primary Key) in corrispondenza della matricola. La chiave primaria PK stà ad indicare che la colonna matricola non potrà contenere valori duplicati, come mostra l’ immagine seguente:

In questo esempio la tabella studenti contiene 6 records tutti con matricola diversa ed ordinati in modalità crescente proprio grazie alla presenza della PK.
Per definizione quindi la Primary Key crea un vincolo che identifica in modo univoco ogni record di una tabella.
Query DDL - Create Table / Alter Table
Possiamo utilizzare anche l’ ambiente di scrittura SQL e scrivere una query per creare la tabella studenti in uno schema scuola
CREATE TABLE scuola.studenti(
matricola INT NOT NULL,
nome VARCHAR(26) NULL,
cognome VARCHAR(26) NULL,
eta VARCHAR(26) NULL,
dn DATE NULL,
PRIMARY KEY (`matricola`));
Allo stesso modo possiamo scrivere una query ALTER TABLE in grado di modificare una struttura tabellare precedentemente creata:
ALTER TABLE scuola.studenti
ADD COLUMN citta VARCHAR(20) NULL AFTER dn,
CHANGE COLUMN nome nome VARCHAR(15) NULL DEFAULT NULL ,
CHANGE COLUMN cognome cognome VARCHAR(15) NULL DEFAULT NULL ,
CHANGE COLUMN eta eta VARCHAR(15) NULL DEFAULT NULL ;
Se invece vogliamo utilizzare il client Workbench per modificare una tabella (Alter Table) oppure inserire record in essa, si può interagire attraverso pulsanti collocati alla destra di ogni tabella presente nello schema.
Infatti è possibile modificare la tabella attraverso il simbolo della chiave meccanica oppure inserire record in essa con il pulsante a forma di griglia.
DML - Data Manipulation Language
Data Manipulation Language è un linguaggio per la manipolazione dei dati veri e propri e comprende una serie di comandi per la creazione la ricerca la modifica e cancellazione dei dati da una tabella. Le operazioni sopra descritte vengono comunemente dette di CRUD ovvero Create, Read, Update, Delete.
Quindi se si vogliono scrivere query per operazioni CRUD possiamo utilizzare sempre l’ ambiente SQL messo a disposizione dal client Workbench. Vediamo ora alcuni esempi dettagliati:
- UPTDATE nome_tabella
Istruzione SQL per elimminare record da una tabella. La sintassi è la seguente:
UPDATE nome_tabella
SET campo = valore
WHERE campo=valore
- DELETE FROM nome_tabella
Istruzione SQL per elimminare record da una tabella. La sintassi è la seguente:
DELETE FROM nome_tabella
WHERE campo = valore
- INSER INTO nome_tabella
Istruzione SQL per modificare record in una tabella. La sintassi è la seguente:
UPDATE O nome_tabella
(campo1,campo2, campo3, ….)
VALUES (valore1,valore2,valore3, ….)
Se la tabella in cui vogliamo inserire record è studenti dello schema scuola, la query da scrivere sarà la segunte:
INSERT INTO scuola.studenti
(matricola,nome,cognome,citta,dn)
VALUES (7,“Giorgio“,“Albertazzi“,“Roma“,”1970-03-02“)
La query è stata scritta in riferimento alla Fig-1 dove si può notare la presenza di altri record in tabella per cui l’ inserimento utilizza la matricola 7 che non esiste.
- SELECT
Con questa istruzione si impostano ricerche su tabelle di uno schema/database. Per affinare o perfezionare le ricerche si utilizzano clausole, operatori e funzioni come quelle di aggregazione, comuni anche con altre istruzioni. La sintassi è la seguente:
SELECT * FROM nome_tabella
Il carattere * indica tutti i campi mentre nome_tabella è la tabella su cui effettuare le ricerche. Vediamo una applicazione:
SELECT * FROM studenti;
Questa query restituisce tutti i record della tabella studenti dello schema scuola selezionato, visualizzando tutti i campi. La successiva invece mostra solo matricola, nome e cognome:
SELECT matricola,nome,cognome
FROM studenti ORDER BY cognome;
La parola chiave ORDER BY può essere aggiunta sempre e per realizzare una lista ad esempio ordinata per cognome oppure con chiave multipla se i campi sono separati da virgola. L’ ordinamento può essere ASC e DESC (default ASC)
ORDER BY nome,cognome DESC;
Operatori Logici e di Confronto
Gli operatori di confronto sono:
> (maggiore) < (minore)
>= (maggiore o uguale)
<= (minore o uguale)
= (uguale) != (not uguale)
Gli operatori logici invece possono essere utilizzati tenendo conto di più simbolismi, vediamo quali:
not !
and &&
or ||
Funzioni del linguaggio SQL
L’ SQL ha molteplici funzioni definite di built-in, ovvero integrate nel linguaggio, che possono essere richiamate attraverso la seguente sintassi:
SELECT funzione(nome_colonna) FROM tabella
Possiamo dividerle in due categorie ovvero quelle di Aggregazione che lavorano su una collezione di valori e restituiscono un valore singolo e quelle Scalari che lavorano su singoli valori e restituiscono singoli valori.
Vediamo le principali funzioni di Aggregazione:
- avg(nome_colonna)
- Restituisce il valore medio di una colonna
- count(nome_colonna)
- Restituisce il numero di righe, escluse quelle null
- count(*)
- Restituisce il numero di righe selezionate
- distinct(nome_colonna)
- Restituisce un numero di righe diverse
- sum(nome_colonna)
- Restituisce la somma dei valori di una colonna
- min(nome_colonna)
- Restiyuisce il valore minimo di una colonna
- max(nome_colonna)
- Restituisce il valore massimo di una colonna
Vediamo le principali funzioni Scalari:
- day(data)
- Restituisce il giorno della data
- month(data)
- Restituisce il mese della data inserita
- year(date)
- Restituisce l’ anno della data inserita
Clausola WHERE
Una clausola frequentemente utilizzata è la WHERE per applicare condizioni alla ricerca, vediamo un esempio:
SELECT * FROM studenti
WHERE matricola >= 1 and matricola <= 4;
SELECT * FROM studenti
WHERE citta = ‘roma‘ or citta=‘venezia‘;
SELECT * FROM studenti
WHERE (citta = ‘roma‘ or citta = ‘venezia‘)
and dn >= ‘2000-01-01‘;
Utilizzare le funzioni in una query di selezione potrebbe essere molto simile all’ esempio seguente che visualizza il nome, cognome e anno di nascita degli studenti (Fig-1) senza applicare condizioni:
SELECT nome,cognome,year(dn)
FROM studenti order by dn
Clausola GROUP BY
Lo statement Group By viene utilizzato per raggruppare righe di una tabella in base ad una o più colonne, come ad esempio raggruppare le città della tabella studenti e contarle. Vediamo un esempio di query che utilizza anche la funzione count(*):
SELECT count(*),citta FROM studenti group by citta;
Nel caso si trattasse di una tabella ordini la query per avere una lista di tutti gli ordini, visualizzando la somma dei totali raggruppati per città, potrebbe essere la seguente:
SELECT sum(totale),citta FROM ordini group by citta;
Gli alias
Gli alias sono una funzionalità del linguaggio SQL che permettono di assegnare un nome alternativo ad una tabella oppure ad una colonna della tabella. Vediamo un esempio di come assegnare un nome temporaneo alla colonna sum(totale) della query scritta sopra:
SELECT sum(totale) as TOTALE,citta
FROM ordini group by citta;
Si può notare che in tutte queste query le condizioni alfanumeriche non sono key sensitive e quindi possono non rispettare le maiuscole e miniscole.
Operatore BETWEEN
La where quindi utilizza anche o soprattutto gli operatori, in questo caso di confronto per realizzare un intervallo. Un operatore simile nel linguaggio SQL è between, vediamo una query di ricerca:
SELECT * FROM studenti
WHERE matricola between 1 and 3;
Ed è possibile utilizzarlo in riferimento anche a campi di tipo date:
SELECT * FROM studenti
WHERE dn between “1930-01-01” and “1965-12-31“;
Ovviamente se non si utilizza l’ operatore between si dovranno utilizzare gli operatori di confronto >= e <= per realizzare un range.
Operatore IN
Un operatore invece appartenente ad un insieme potrebbe essere il seguente:
SELECT * FROM studenti
WHERE citta in(‘roma‘ , ‘venezia‘);
E’ possibile anche utilizzarlo con più parametri sia alfanumerici che valori numerici.
in(1300,2000,1500)
Operatore ANY
L’operatore “ANY” in MySQL viene utilizzato per confrontare un’espressione con un insieme di valori restituendo “True” se l’espressione corrisponde a qualsiasi valore dell’insieme, altrimenti restituisce “False”. L’operatore “ANY” può essere utilizzato in combinazione con i seguenti operatori di confronto:
“=“, “!=“, “>“, “<“, “>=“, “<=“, “<>“, “like“, “not like“, “in“, “not in“.
Ecco un esempio:
SELECT * FROM table_name
WHERE column_name = ANY (1, 2, 3);
Operatore LIKE
Nel linguaggio SQL un operatore di confronto abbastanza utilizzato è Like e basa le sue condizioni su due simboli la % ed il trattino basso o underscore ( _ ) dove il primo sostituisce un insieme di caratteri mentre il secondo un numero preciso, vediamo un esempio:
SELECT * FROM studenti
WHERE citta like “v%”;
Anche questo operatore non è key sensitive, infatti non è necessario specificare esattamente le maiuscole e minuscole nelle condizioni.
Clausola HAVING
La clausola having in SQL viene utilizzata per filtrare i risultati di una query sulla base di condizioni specifiche sugli aggregati di un gruppo di righe.
La clausola having viene utilizzata in combinazione con l’istruzione group by e viene applicata dopo il calcolo degli aggregati e prima che i risultati vengano restituiti.
Ad esempio, se si desidera estrarre le informazioni sulla quantità totale di vendite per ogni mese e poi filtrare i risultati per visualizzare solo i mesi in cui le vendite sono state superiori a un determinato valore, si può utilizzare la clausola having. In questo caso mostriamo la tabella contenete le vendite dei clienti:

La Query SQL potrebbe essere la seguente se utilizzamo anche gli alias:
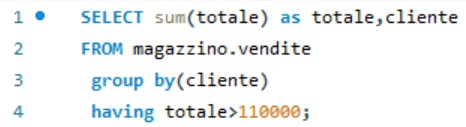
In questo esempio, la query raggruppa le vendite per mese e calcola la quantità totale di vendite per ogni mese. La clausola having viene utilizzata per filtrare i risultati e visualizzare solo i mesi in cui la quantità totale di vendite è superiore a 110000.
Query Annidate
Le query annidate sono una tecnica avanzata di SQL che consente di creare query che si basano su altre query. In altre parole, una query annidata è una query che viene utilizzata come sottoconsultazione all’interno di un’altra query. Possiamo dimostrare questo utilizzando una sola tabella o più tabelle.
Nel prossimo esempio verrà utilizzata una sola tabella studenti, come la seguente:

Con le query annidate possiamo ottenere una lista di tutte le persone che hanno l’ età superiore a quella dei residenti a ‘Roma‘ :

Quindi in presenza di query e sottoquery l’ esecuzione avviene partendo dalla query più interna per poi proseguire verso l’ esterno. Nell’ esempio sopra al run viene eseguita la query della media (avg) producendo un valore, per poi confrontare ogni valore della prima SELECT con esso.
Un esempio molto simile può essere realizzato con la seguente tabella ordini (Fig-1) da cui vogliamo estrarre tutti i record il cui importo è superiore alla media di tutti gli importi:

La query da realizzare potrebbe essere la seguente:

- Operatore IN – Query Annidate
- Come è stato detto in precedenza l’ operatore IN è utilizzato per verificare se un valore esiste in un sottoinsieme di valori. Osserviamo le tabelle da cui estrarre i dati utilizzando sottoquery:

In questa siatuazione ad esempio possiamo estrarre tutte le persone residenti in Lombardia, vediamo la query da scrivere:
SELECT * FROM Persone
WHERE Residenza
IN ( SELECT citta FROM Citta
WHERE Regione = “Lombardia” )
Il DBMS quindi esegue prima la query interna trovando le città Bergamo e Milano, poi esegue la SELECT su Persone in cui la Residenza è un valore appartenente al risultato della query precedente.
- Operatore ANY – Query Annidate
- Utilizzato per confrontare un’ espressione con un insieme di valori che potrebbero essere anche valori di una sottoquery. Vediamo le tabelle per realizzare l’ esempio:

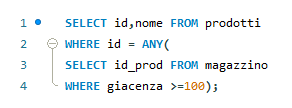
Tabelle Relazionate
Le relazioni tra le tabelle in MySQL sono un aspetto fondamentale della progettazione di un database relazionale. Le relazioni consentono alle tabelle di essere collegate tra loro e di fornire un modo efficiente per recuperare le informazioni dai dati.
Ci sono diversi tipi di relazioni che possono essere create tra le tabelle di MySQL, tra cui:
Relazione uno a uno (one-to-one): in questa relazione, ogni riga nella tabella A è collegata a una sola riga nella tabella B e viceversa. Questa relazione è utile quando si desidera separare le informazioni in due tabelle per motivi di normalizzazione del database.
- Relazione uno a molti (one-to-many): in questa relazione, ogni riga nella tabella A può essere collegata a molte righe nella tabella B, ma ogni riga nella tabella B è collegata a una sola riga nella tabella A. Questa relazione è comunemente utilizzata quando si ha una tabella principale e una tabella secondaria, e si desidera collegare le informazioni nella tabella secondaria alla tabella principale.
- Relazione molti a molti (many-to-many): in questa relazione, ogni riga nella tabella A può essere collegata a molte righe nella tabella B, e viceversa. Per creare questa relazione, è necessario utilizzare una tabella di associazione che collega le chiavi primarie delle due tabelle.
Creare un relazione 1:1
L’ esempio utilizza una chiave primaria di tpo INT ma ovviamente le relazioni in genere possono essere realizzate con qualsiasi tipo di chiave.
Per creare una relazione uno-a-uno tra due tabelle in MySQL è necessario utilizzare chiavi primarie (primary key) e vincoli di integrità (foreign key). Un esempio potrebbe essere tra la tabella ‘studenti‘ e la tabella ‘anagrafica‘.

Di seguito i tracciati record delle due tabelle:

E la creazione di una ForeignKey in Anagrafica:
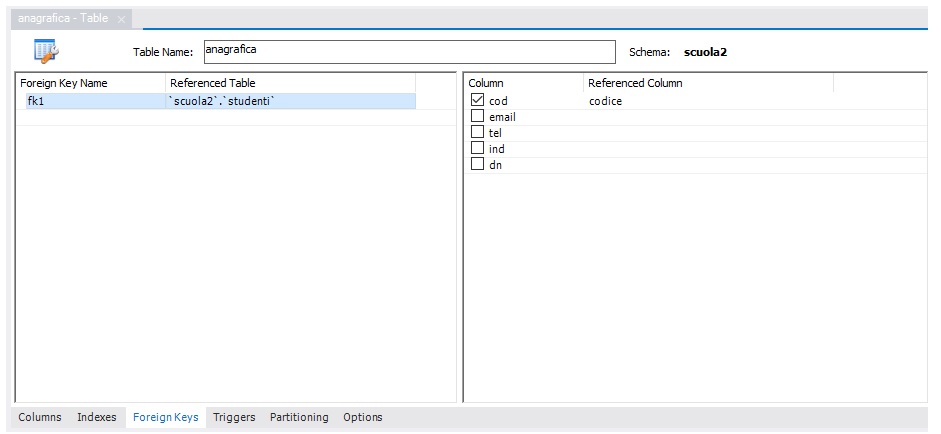
Analizziamo la relazione iniziando dalla tabella Studenti dove possiamo notare la presenza della chiave PK sul campo codice che è di tipo INT, la corrispondente chiave dello stesso tipo (INT) è in Anagrafica ed è il campo cod, quindi possono essere di nome diverso ma il tipo deve essere lo stesso per entrambe le chiavi.
A questo punto se le due chiavi sono entrambe PK significa che per ogni valore della chiave codice in Studenti corrisponde un solo valore della chiave PK in Anagrafica. Nell’ esempio riportato sopra il codice 10 può essere presente una sola volta in Studenti, mentre in Anagrafica (cod) può essere presente al massimo una sola volta oppure non esserci affatto (relazione 1:1). Questo ovviamente è dovuto alla presenza delle PK nelle tabelle Studenti ed Anagrafica.
Le relazioni 1:1 possono essere realizzate tra due o più tabelle, ovvero Studenti è relazionata 1:1 con Anagrafica ma questa può anche essere relazionata 1:1 con un’ altra tabella, come ad esempio Dettagli.
Sempre in riferimento alla relazione 1:1 tra Studenti ed Anagrafica applichiamo un vincolo di integrità referenziale alla tabella Anagrafica utilizzando la chiave esterna ForeignKey (Fig-1). Questo significa che la tabella Anagrafica non potrà mai contenere un valore della chiave cod che non sia presente nella tabella Studenti (codice). Con questa logica non è possibile inserire una anagrafica se non c’è il corrispondente studente (vincolo di integrità referenziale in Anagrafica).
La relazione 1:m in MySQL rappresenta una relazione tra due tabelle in cui ogni riga della tabella principale è correlata a molte righe della tabella secondaria, ma ogni riga nella tabella secondaria è correlata solo ad una singola riga nella tabella principale.
Per comprendere meglio questa relazione, consideriamo un esempio: una tabella Clienti potrebbe avere una relazione 1:m con una tabella Ordini. In questo caso, ogni riga della tabella Clienti rappresenta un ordine generale effettuato dal cliente, mentre ogni riga nella tabella Ordini rappresenta un prodotto specifico ordinato in quell’ordine:
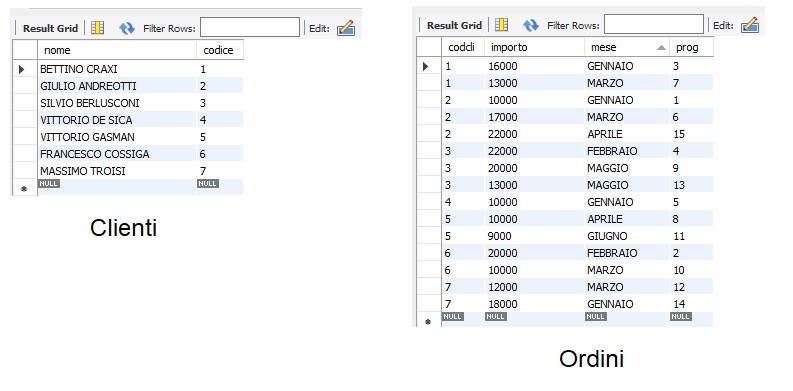
Osserviamo il il tracciato record delle due tabelle relazionate:

In questo esempio per convenzione la tabella Clienti è quella madre mentre Ordini è la figlia e la relazione avviene tra i campi codice (PK INT Clienti) e codcli (INT Ordini).
Quindi ogni valore della chiave PK codice in Clienti è presente una sola volta mentre lo stesso valore può essere presente molteplici volte nella tabella Ordini (codcli) oppure non esserci affatto (1:m). Ovviamente il valore di una chiave che si ripete molteplici volte nella tabella Ordini corrisponde ad un solo valore nella tabella Clienti (codice)
In Fig-2 viene mostrato come creare un INDEX, necessario per configurare la Foreign Key, sulla tabella Ordini, anche se Workbench crea in automatico l’ INDEX al momento della creazione di Foreign Key.
Creare un relazione molti a molti